はじめに
前回の記事では、RTX 3060 12GB の自宅サーバの RAM を 80GB に増やし、Strata で 125B の MoE モデル Qwen3.8-Flash-Next を動かしました。最後に「RTX 5060 Ti の追加は、速度が足りなくなったときか画像生成を本格化するときに改めて考える」と書いていましたが、画像生成(ComfyUI)を本格的に使いたくなったので、今回追加しました。
結論から書くと:
- RTX 5060 Ti 16GB を足して 2 枚構成にし、Qwen3.8-Flash-Next と ComfyUI を同時に動かせるようになった
- 認識させるまでにかなりハマった。原因は BIOS の古さとカードの挿さりの浅さ
- どのスロットに挿すかで LLM の速度が大きく変わった。 チップセット経由のスロットに 3060 を移したら約 24% 遅くなり(51.5 → 39.3 tok/s)、Strata を 5060 Ti に移したら 71〜72 tok/s になった
環境
| 項目 | 内容 |
|---|---|
| CPU | Ryzen 5 5600X(内蔵 GPU なし) |
| マザーボード | ASRock B550M Steel Legend |
| RAM | DDR4 80GB(前回増設): Corsair Vengeance LPX 32GB×2 + Vengeance RGB Pro 8GB×2、DDR4-3000 手動設定 |
| GPU 1 | RTX 3060 12GB |
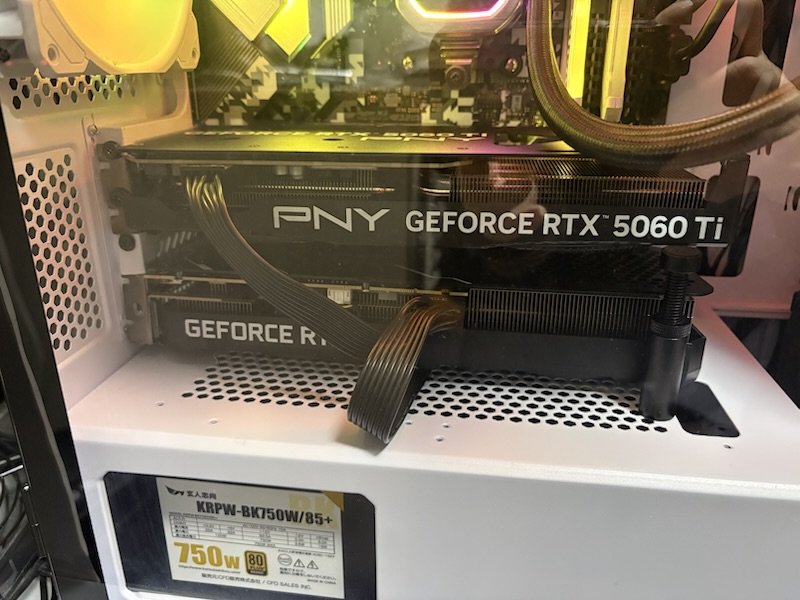
| GPU 2(今回追加) | PNY RTX 5060 Ti 16GB |
| 電源 | 玄人志向 KRPW-BK750W/85+(750W・80PLUS Bronze、PCIe 8pin×2) |
| ケース | Thermaltake S100 TG Snow Edition(mATX ミニタワー) |
| OS | Ubuntu 24.04、NVIDIA ドライバ 580(open) |
電源の PCIe 8pin が 2 本しかないので、3060(8pin×1)と組み合わせられるのは 8pin×1 のカードに限られます。5060 Ti を選んだ理由の一つです。消費電力は 3060(170W)+5060 Ti(180W)+5600X(約 90W)で、750W に収まります。
追加前の困りごと
前回の記事のとおり、GPU が 1 枚だったので、Strata(VRAM を約 11GB 使う)と ComfyUI は同時に動かせませんでした。「先に使っている方が優先」というルールで譲り合わせていたので、画像生成をしている間はエージェントが Strata を使えず、その逆も起きていました。
取り付けでハマったこと
挿しただけでは認識されませんでした。順に書きます。
1. PCIe バスにまったく出てこない
ファンは回っているのに、lspci に何も出ません。PCIe のスロット側を詳しく見ると、「カードが挿さっていることは検知しているのに、リンク幅が x0(通信できていない)」という状態でした。
BIOS が 2023 年の版(P2.80)で、RTX 50 シリーズより古かったので、最新版(P4.00)に更新しました。あわせて次のように設定しました。
- CSM: 無効
- Above 4G Decoding: 有効
- Re-Size BAR Support: 有効
ネットで調べると、RTX 5060/5060 Ti には「古いマザーボードで画面が出ない」という既知の不具合があり、NVIDIA がカード側のファームウェア更新ツールを出していました。ただ、このツールはカードが OS から見えていないと使えません。
2. 本当の原因は挿さりの浅さ
BIOS を更新しても状況は変わりませんでした。ブラケットはケースにぴったり付いているのに、カードの端子がわずかに浮いていたのが原因でした。挿し直すたびにリンク幅が x1 → x4 → x8 と良くなっていきました。どうも元々、このケースはブラケット固定位置だと浅めになるようで、ブラケットを少し曲げて深く刺さるようにしてなんとか凌ぎました。あと、RTX3060とRTX5060Tiだと5060の方がわずかに浅くてほんとに0.xmmの世界ですが、それが認識するしないの分かれ目でした。
PCIe の端子は、1 本目のレーンが手前、2 本目以降が奥に並んでいます。浅いと手前だけが触れて x1 になります。x1 でも一応動くので、気づきにくいところです。
リンク幅は次のコマンドで確認できます。
nvidia-smi --query-gpu=name,pcie.link.gen.max,pcie.link.width.current --format=csv
journalctl -k -b 0 | grep 'available PCIe bandwidth'
3. 下のスロットでは最後まで認識しなかった
このマザーボードの x16 形状のスロットは 2 本です。
| スロット | つながり先 | 規格 |
|---|---|---|
| 上(PCIE1) | CPU 直結 | PCIe 4.0 x16 |
| 下(PCIE3) | チップセット経由 | PCIe 3.0 x4 |
5060 Ti の方が薄いので下に挿したかったのですが、下のスロットでは最後まで認識されませんでした。このケース(S100)では一番下のスロットに挿すとカードがケースに当たって少し無理がかかるので、その分浅くなっていたのだと思います。3060 は下でも動くので、5060 Ti を上、3060 を下にしました。結局、ケースのブラケットパネルのリベットが干渉するのでニッパーでカットしてかなり強引に入れてます。ちょっとカードやマザーにテンション掛かってるので心配ではありますが。。。
4. 使用中にバスから外れた
蓋を閉めて運用を始めた夜、使用中に 5060 Ti が Xid 79: GPU has fallen off the bus で外れました。熱や電力が原因ではなく(49℃・20W のときでした)、接触の問題と見て挿し直し、今は安定しています。
念のため、サーバの監視に「GPU の枚数」「GPU ごとの PCIe リンク幅」「PCIe のエラー」を足し、落ちたら Discord に通知が来るようにしました。
スロットで LLM の速度が変わった
最初は、それまでどおり Strata を 3060、ComfyUI を新しい 5060 Ti に割り当てました。すると Strata が目に見えて遅くなりました。
原因は、3060 を下のスロットに移したことです。上の PCIe 4.0 x16 は約 32 GB/s、下の PCIe 3.0 x4 は約 4 GB/s と、帯域が 1/8 になります。
Strata は全エキスパート(約 40GB)を RAM に置き、よく使うエキスパートだけを VRAM にキャッシュします。キャッシュに無いエキスパートと、長い会話の KV キャッシュ(32K トークンを超えた分)は PCIe 越しにやり取りするので、帯域がそのまま速度に出ました。
一方、画像生成はモデルを VRAM に読み込んだ後はほとんど PCIe を使いません。そこで担当を入れ替えて、Strata を 5060 Ti、ComfyUI を 3060 にしました。
graph LR
    CPU["Ryzen 5 5600X
RAM 80GB"] -- "PCIe 4.0 x8" --> G1["RTX 5060 Ti 16GB
Strata(Qwen3.8-Flash-Next)"]
    CPU -- "チップセット経由
PCIe 3.0 x4" --> G2["RTX 3060 12GB
ComfyUI"]
あわせて Strata を最新版に更新し、エンジンを 5060 Ti の世代(sm_120)向けにもビルドし直しました(前回の導入時は 3060 の sm_86 向けだけでした)。GPU ごとに担当を分けたので、前回作った「譲り合い」の仕組みのうち、ComfyUI と Strata の間の排他は外しました。
速度の比較
Qwen3.8-Flash-Next(IQ3_XXS)の生成速度です。
| 構成 | メモリ | 生成速度 | VRAM 上のエキスパート | キャッシュ命中率 |
|---|---|---|---|---|
| 3060・上のスロット(PCIe 4.0 x16) | DDR4-3000 | 51.5 tok/s(普段使いの平均) 約 62 tok/s(前回記事の短い試行) |
約 3000 個(4.9 GiB) | 71% |
| 3060・上のスロット(PCIe 4.0 x16) | DDR4-2133 | 48.5 tok/s(普段使いの平均) | 約 3000 個(4.9 GiB) | 73% |
| 3060・下のスロット(PCIe 3.0 x4) | DDR4-2133 | 37.2 tok/s(普段使いの平均) | 約 3000 個(4.9 GiB) | 66% |
| 3060・下のスロット(PCIe 3.0 x4) | DDR4-3000 | 39.3 tok/s(普段使いの平均) | 約 3000 個(4.9 GiB) | 60% |
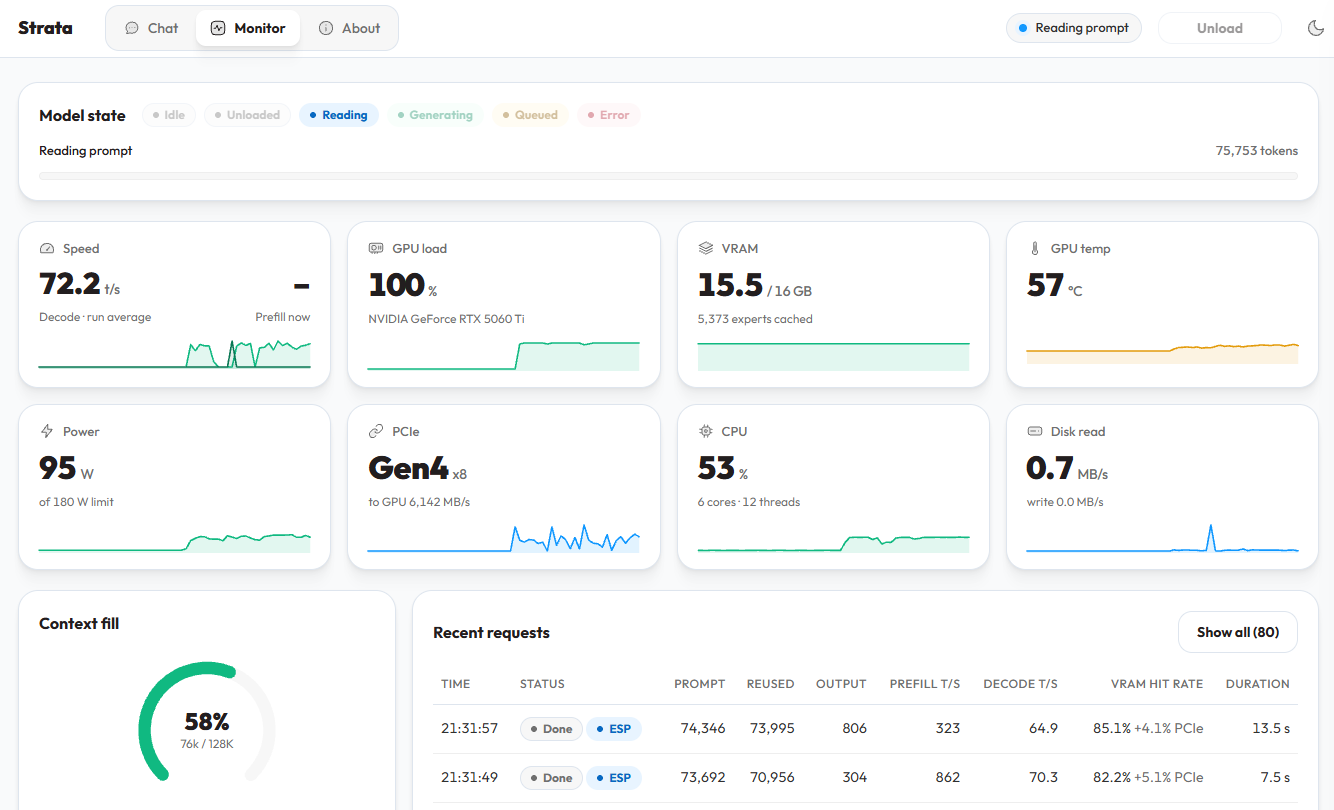
| 5060 Ti・上のスロット(PCIe 4.0 x8) | DDR4-3000 | 71〜72 tok/s(短い試行 2 回) | 5373 個(8.7 GiB) | 83〜86% |
- 「普段使いの平均」は、エージェントから使っているときのログを期間ごとに平均した値です(500 トークン以上の回答のみ)。長い会話が多いので、短い試行より低く出ます。
- メモリが DDR4-2133 の行があるのは、BIOS を更新したときに前回手で入れたメモリ設定(DDR4-3000)が消えて、自動の 2133 に戻っていたためです。 気づいて 3000 に戻すまでの約 1 日半のデータです。BIOS 更新後はメモリ設定の入れ直しを忘れずに。
- 同じメモリ速度で比べると、3060 を下のスロットに移しただけで 約 24% 遅くなりました(DDR4-3000 で 51.5 → 39.3、2133 で 48.5 → 37.2)。メモリ速度の違い(3000 と 2133)による差は約 6% なので、スロットの帯域の影響の方がずっと大きいです。
- 5060 Ti の値は、入れ替え直後に 800 トークンと 3000 トークンを生成させた 2 回だけの値です。同じ条件の短い試行同士(前回の約 62 tok/s)で比べると、約 1.15 倍です。
5060 Ti では VRAM が 16GB に増えたぶん、Strata がエキスパートのキャッシュを自動でほぼ倍に取りました。キャッシュに当たる割合が上がり、PCIe でやり取りする量が減ったことが、速くなった一番の理由だと思います。
まとめ
- RTX 5060 Ti を足して、ローカル LLM(Qwen3.8-Flash-Next)と画像生成(ComfyUI)を同時に動かせるようになった
- Strata のように RAM と GPU の間でエキスパートをやり取りする推論では、GPU の性能だけでなく、挿すスロットの帯域と VRAM の量で速度が大きく変わる。チップセット経由のスロットは LLM 向きではない
- 新しい GPU が認識しないときは、BIOS の更新と、挿さりの深さ(リンク幅)を疑う。x1 でも動いてしまうので、リンク幅を見て確かめる
- BIOS を更新すると、手で入れたメモリ設定が消える。前回 DDR4-3000 に合わせたメモリが 2133 に戻っていた
次は普段使いの平均がどこまで上がるかを、しばらく様子を見るつもりです。
参考
- 前回の記事: RTX 3060 12GB の自宅サーバで 125B の Qwen3.8-Flash-Next を動かす ― メモリ80GBに増設と Strata 導入記
- Strata(GitHub): https://github.com/Niko1221/Strata