OpenClaw 2026.5.2 Discord 切断事件

何が起きたのか

OpenClaw を 2026.4.29 から 2026.5.2 に更新したら、Discord bot が繋がらなくなった。実は2026.4.26->2026.4.29に上げたときもDiscordに繋がらなくなったのですが、今回も繋がりませんでした(苦笑) こういう時は openclaw doctor –fixが推奨なんですが、最近私はClaudeCode様任せです(笑)ClaudeCodeさんにお願いして調べてみたところ、OpenClaw 2026.5.1 で大きなアーキテクチャ変更があったそうで。Discord を含む多くのチャンネルプラグインが、コアパッケージから外部 npm パッケージへ externalized されたのだそうだ。え。。。て感じだけど。「 bundled plugin → 独立パッケージ 」への cutover 最中に openclaw update を実行すると、プラグインの依存関係が解決されず、Discord プラグインが missing になる。結果として Gateway は起動しても Discord チャンネルが接続できず、bot が「オンラインなのに返事しない」状態になる。とのことだった。。。

原因の技術的な背景

CHANGELOG を見ると、2026.5.1 の Plugins/beta セクションにこうある:

prepare Google Chat, LINE, Matrix, Mattermost, …, Discord, …, WhatsApp, Brave, Codex, … for 2026.5.1-beta.1/2026.5.1-beta.2 npm and ClawHub publishing

つまり Discord プラグインは @openclaw/channel-discordcode>@openclaw/channel-discord</code などの独立パッケージとして npm に公開されることになり、コアに含まれなくなった。update 時にこの移行が中途半端だと、プラグインがインストールされていないままになる。

2026.5.2 の修正

2026.5.2 にはこの問題への対応が Doctor/plugins セクション で行われた:

run a one-time 2026.5.2 configured-plugin install repair based on meta.lastTouchedVersion, update stale configured plugin manifests that still declare channels without channelConfigs, install actively used downloadable OpenClaw plugins through the configured external source

要するに、update 時に missing プラグインを自動検出して再インストールする repair が追加された。これで 2026.5.2 以降に update しても同じ事象は起きにくくなっている。

教訓

  1. メジャー cutover の直後は注意: プラグインの externalization のような大きな変更があるバージョンでは、update 後に openclaw doctor --fix を実行するのが安全
  2. CHANGELOG を読む癖をつける: openclaw update の前に CHANGELOG を一瞥するだけで、こんな事象は避けられた
  3. openclaw status で確認: 更新後に openclaw status を実行してチャンネルの状態を確認する

まとめ

OpenClaw は気軽に openclaw update すると 100% ハマるよねぇ(笑)。でもそれはつまり、開発が活発で頻繁に更新されている証拠でもある。プラグインの外部化はスケーラビリティ向上のためなので、ある意味必要な進化。update 後は doctor を実行する癖をつけましょう。


この記事はOpenClaw + Ollama Qwen3.6-35b-a3bで書かれた原稿を元にしています。

OpenClaw+ClaudeCodeで補完する

概要

OpenClawはClaudeCodeに比べるとまだまだ不安定で色々いじるとすぐ動かなくなる。それにローカルLLMを使っているのでClaudeほど賢くない。そこで、Claude CodeにOpenClawの管理者・先生となってもらって、OpenClawを育てれ見ようと思った。

相互補完の関係

  • ClaudeCodeBot-a10 1 → OpenClawの不安定な状態のメンテナンスや指示出しを担当
  • OpenClaw → ClaudeCodeBot-a10の再起動や状態監視を担当

実現した機能

  1. Discordを通じた人間とのコミュニケーション: Discordチャンネルから直接操作
  2. Remote Control機能を使ったオペレーション: iPhoneアプリからリモート操作
  3. 常駐化による安定運用: コンテキスト維持と即時応答

この構成により、AIアシスタント同士の協調作業と、人間からの柔軟な操作インターフェースを実現しました。

背景: AIアシスタントの相互補完システム

OpenClawは強力なAIアシスタントですが、以下のような課題がありました:

  1. 不安定な状態の回復: 設定変更やトラブル発生時の自己修復
  2. 継続的な監視: 24時間のヘルスチェックとアラート
  3. 人間とのインターフェース: Discordやモバイルからの直感的な操作

これらの課題を解決するために、OpenClawを補助するClaude Codeセッションを常駐化し、相互に監視・制御するシステムを構築しました。

構成図

graph TB
    subgraph "サーバ (a10)"
        O[OpenClaw Gateway] -->|スキル管理| TM[tmux セッション
claudecode-discord] TM --> C[Claude Code
--channels server:openclaw-discord] C -->|remote-control URL| URL[https://claude.ai/code/session_XXX] end subgraph "リモートアクセス" DISC[Discord
#claude-claw] -->|/claudecode-bot コマンド| O IPH[iPhone Claude App] -->|ブラウザから
初回アクセス| URL IPH -->|セッション一覧| SESH[セッション管理画面] end TM -->|管理コマンド| MNG[OpenClaw スキル
start/stop/restart/status]

構築内容

1. ClaudeCodeBot-a10の概要

役割: OpenClawの補助・管理

  • OpenClawの設定変更やトラブルシューティングの支援
  • Discordチャンネルでの指示受け取りと実行
  • 定期的なヘルスチェックとメンテナンス

2. claude --channels常駐方式の構成

従来のワンショット方式から常駐方式に変更:

tmux new-session -d -s claudecode-discord \
  'claude --channels server:openclaw-discord \
   --dangerously-load-development-channels server:openclaw-discord'

設定のポイント:

  • tmuxセッションを使用して端末接続が切れても継続
  • --channelsフラグで特定のDiscordサーバーに接続
  • 開発チャンネルも読み込むオプション付与
  • 起動時の確認プロンプトを自動応答

3. OpenClawスキルによるリモート管理

OpenClawのスキルとしてclaudecode-botを実装し、Discordから直接管理可能にしました:

# Discordでのコマンド例
/claudecode-bot status    # 稼働状態確認
/claudecode-bot start     # 起動
/claudecode-bot stop      # 停止  
/claudecode-bot restart   # 再起動

スキルの特徴:

  • tmuxセッションの状態を自動検出
  • 起動時の確認プロンプトを自動応答
  • エラーハンドリングとログ取得
  • ユーザーフレンドリーな日本語応答

4. remote-controlでアプリから操作できる仕組み

Claude Codeのremote-control機能を活用:

  1. 自動URL生成: Claude Code起動時にremote-control URLが表示される
  2. 初回アクセス: ブラウザでこのURLを開くとiPhone Claudeアプリのセッション一覧に登録
  3. 常時接続: 以後はアプリから直接セッションに接続可能
# remote-control URLの例
https://claude.ai/code/session_abc123def456?token=xyz789

5. iPhoneアプリとの連携

セットアップ手順:

  1. Claude Codeを起動しremote-control URLを取得
  2. iPhoneのブラウザでURLを開く
  3. 「Claudeアプリで開く」を選択
  4. セッション一覧にClaudeCodeBot-a10として表示される
  5. 以後はアプリから直接操作可能

メリット:

  • モバイルからもOpenClawの補助AIにアクセス可能
  • セッション状態が維持される(コンテキスト保持)
  • 通知やアラートの受信が可能

技術的詳細

tmuxセッション構成

# セッション起動スクリプト(自動応答付き)
tmux new-session -d -s claudecode-discord \
  'claude --channels server:openclaw-discord \
   --dangerously-load-development-channels server:openclaw-discord' && \
sleep 3 && tmux send-keys -t claudecode-discord "1" Enter && \
sleep 3 && tmux send-keys -t claudecode-discord "1" Enter

OpenClawスキル実装

~/.openclaw/workspace/skills/claudecode-bot/SKILL.mdに管理ロジックを実装:

---
name: claudecode-bot
description: Manage the ClaudeCodeBot-a10 Claude Code session
---

# ClaudeCodeBot-a10 セッション管理

## 状態確認
tmux list-sessions | grep claudecode-discord

## 起動・停止・再起動
自動的にtmuxセッションを制御

セキュリティ考慮事項

  1. 環境変数使用: APIトークンは環境変数で管理
  2. 制限付きアクセス: 特定のDiscordチャンネルのみ許可
  3. 監視ログ: tmuxセッションの出力を定期的に監視

運用メリット

相互補完システムの効果

項目 効果 実現機能
相互監視 一方がダウンしても他方で再起動可能 自己修復システム
コンテキスト維持 長期的なプロジェクト管理が可能 継続的な作業フロー
多様なインターフェース ユーザーの状況に合わせた操作 Discord + モバイルアプリ
常時待機 即時応答による迅速なトラブル対応 24時間監視体制
メンテナンス相互補完 OpenClawの不安定状態をClaude Codeで修復 相互依存関係

実際のユースケース

  1. 深夜の緊急対応: モバイルからOpenClawのトラブルシューティングを指示
  2. 定期的なメンテナンス: ヘルスチェックとログ監視の自動化
  3. プロジェクト管理: 長期的な開発プロジェクトのコンテキスト維持
  4. チーム連携: Discordチャンネルを通じた複数メンバーからの指示受け付け

トラブルシューティング

よくある問題と解決策

  1. tmuxセッションが見つからない
    # セッション一覧確認
    tmux list-sessions
    
    # 強制再起動
    tmux kill-session -t claudecode-discord 2>/dev/null
    /claudecode-bot restart
    
  2. remote-control URLが表示されない
    • Claude Codeの起動ログを確認
    • tmux capture-pane -t claudecode-discord -p | grep -E "remote-control|Listening"
    • ネットワーク接続を確認
  3. iPhoneアプリにセッションが表示されない
    • 初回アクセスでブラウザからURLを開く必要あり
    • 「Claudeアプリで開く」オプションを選択
    • アプリの再起動を試す

まとめ

ClaudeCodeBot-a10システムの構築により、以下の相互補完関係を実現しました:

  1. 相互監視・制御: OpenClawの不安定状態をClaude Codeでメンテナンスし、Claude Codeの再起動をOpenClawで実行
  2. 多様な操作インターフェース: Discordを通じた人間とのコミュニケーションと、Remote Control機能によるモバイルオペレーション
  3. 常駐化による安定性: コンテキスト維持と即時応答可能な常駐システム
  4. 自己修復システム: AIアシスタント同士の協調による高い信頼性

この構成は、AIアシスタント同士の相互補完と、人間との柔軟なインタラクションを両立する効果的なパターンとして、同様のユースケースに適用可能です。


最終更新: 2026年5月3日構成バージョン: Claude Code 2.1.126 + OpenClaw 2026.4.x + tmux 3.3a


  1. a10というのは動いてるサーバの名前です。他にもClaudeCodeBotが居るので後ろに-サーバ名書いてます。 ↩

OpenClaudeを使ってみた

はじめに

OpenClawの導入とは別の話として、最近「Claude Code Proのトークン不足を補う方法」を探していました。

Claude Code Proは優秀ですが、トークンが足りない。かといって全てをローカルLLMに任せるのも限界がある。そこで注目したのが、OpenClaudeというアプローチでした。

OpenClaudeのコンセプト

OpenClaudeはClaude Codeのリソースをそのまま利用できる設計になっています。Claude Codeが持っているリソースをOpenClaw側からも使えるようにするもので、シームレスに作業を引き継げる可能性があるということです。

検討していた内容はこんな感じ:

  • Claude Code Proのトークン不足を補うためにOpenClawを活用
  • OpenClaudeでDeepSeek-v4-flash、v4-pro、kim-k2.6などを使い分け
  • 最適なコーディング環境を整える

具体的には、OpenRouter経由で複数のモデルを切り替えながら、コーディングタスクごとに最適なモデルを使うという戦略でした。

OpenRouter経由でのモデル切り替え

OpenClawはOpenRouterを直接サポートしています。設定はシンプル:

{
  "model": {
    "primary": "openrouter/deepseek/deepseek-v3.2",
    "fallbacks": [
      "openrouter/deepseek/deepseek-v4-flash",
      "openrouter/google/gemini-2.5-pro"
    ]
  }
}

切り替えもDiscordから:

/model openrouter/deepseek/deepseek-v4-flash

OpenClaudeを使ってみたが……

期待していたのは、「modelコマンドで気軽にモデルを変更できる」というところでした。

が、使ってみるとそう簡単にはいかないことがわかりました。

/model コマンドでモデルを切り替えると、~/.claude/settings.json にモデル設定が永続保存されてしまいます。PowerShellから素の claude を起動した瞬間にDeepSeekになってる。意図した元のAnthropicモデルに戻すのが大変でした。

alias cc-deep='claude --model deepseek/deepseek-v4-flash'
alias cc-pro='claude --model anthropic/claude-pro'
alias cc-kimi='claude --model kimi-k2.6'

エイリアス経由で凌ぐことになりましたが、それでも settings.json に model キーが書き込まれていたら手動で削除する必要がありました。

しかも本家のClaude Codeでも同じようにLLMを切り替えられる

もっと気づいておくべき点了——本家のClaude Code自体が既にLLMの切り替えに対応しているんです。

OpenClaude経由で頑張らなくても、Claude Code上で /model コマンドかエイリアスで十分モデルを切り替えられます。OpenClaudeを挟む意味がそもそもないことに気づきました。

結果:メリットを感じなかった

正直に言うと、OpenClaudeのメリットを実感できませんでした。

  1. 切り替えの摩擦が大きい — /model コマンドが設定を破壊する、エイリアスの管理が面倒
  2. レート制限が安定しない — OpenRouterの共有エンドポイントの429エラーが頻発
  3. 本家と変わらない — Claude Codeだけで十分モデルは切り替えられる
  4. Ollama + Qwen3.6で十分 — ローカルモデルの進化が予想より速く、複雑なタスクでも128Kコンテキストがあれば対応可能

OpenClaude経由のモデル切り替えは断念しました。

OpenRouterのレート制限問題

あともう一つ、OpenRouter経由でdeepseek-v4-flashを使った際に問題があったのが、レート制限です:

429 Provider returned error: deepseek/deepseek-v4-flash is temporarily rate-limited upstream.
Please retry shortly, or add your own key to accumulate your rate limits.

これがDiscordへの重複メッセージ送信を引き起こしました。同一のrunIdが429を返し、リトライのたびにDiscordへ再送信していたのが原因でした。

fallbackループが重なり、stuck sessionも発生しました。

最終的に、プライマリモデルを deepseek-v3.2 に変更し、v4-flashをfallbackに降格することで落ち着きました。

今の運用

現在の運用はシンプルになりました:

用途 モデル 場所
日常会話・軽量タスク Ollama Qwen3.6-35b-a3b ローカル(無料)
複雑な問題解決 OpenRouter DeepSeek v3.2 クラウド(数円)
コーディング特化 Claude Code(Anthropic) クラウド(Pro)

OpenClaude経由のモデル切り替えは断念しましたが、これはこれで良かったと思っています。

まとめ

LLMの使い分け戦略を探求したのは良い経験でした。得られた教訓:

  • 切り替えコストを見積もれ — 設定の破壊力、管理の手間を軽視してはいけない
  • 共有レート制限は信用するな — 無料または共有のエンドポイントに依存しない
  • ローカルモデルの進化は凄い — Qwen3.6-35b-a3bで思ったより高い品質が得られる
  • 既存ツールは思いのほか強力 — OpenClaudeのような回り道をせずとも、本家Claude Codeで十分

OpenClawのマルチモデル戦略はまだ途中ですが、「適材適所」というキーワードは揺るぎません。次はサブエージェントを挟んだ自動モデル選択に挑戦してみたいですね。


この記事は、OpenClaw + Ollama Qwen3.6-35b-a3b によって作成され、人間が微調整しました。失敗も記録に残すのがエンジニアの誠実さ。

OpenClaw v2026.4.26 アップデートで起きた無限ループとその解決策

はじめに

OpenClaw は AI エージェントプラットフォームとして Discord との連携が非常に便利です。しかし、2026-04-26 に v2026.4.26 にアップデートしたところ、想定外のトラブルに遭遇しました。Discord チャンネルで無限ループが発生し、OpenClaw が自分自身のメッセージに延々と応答し続ける状態になりました。

この記事では、発生した問題の詳細、その原因、そして効果的な解決策について共有します。

起きたこと

問題の発覚

2026-04-26 に OpenClaw を v2026.4.26 にアップデートした後、#blog チャンネルで奇妙な現象が発生しました。

  1. 無限応答ループ

    • OpenClaw が自分自身の Discord 出力メッセージを新しいユーザー入力として認識
    • そのメッセージに対し、さらに応答を生成
    • 生成した応答をまた入力として認識……と際限なく続く
  2. リソース消費の急増

    • セッションファイルが 657KB まで膨れ上がり(通常は数十KB程度)
    • openclaw-gateway プロセスが CPU を 19% ずっと使い続ける
    • 応答が止まらず、チャンネルがスパム状態に
  3. 手動介入が必要

    • openclaw-gateway の再起動でとりあえず納まった

原因調査

問題の原因を深堀りしていくと、いくつかの設定の組み合わせが影響していることがわかりました。

1. allowBots: true 設定

"channels": {
  "discord": {
    "allowBots": true
  }
}

この設定は以前から使用していました。Claude CodeとOpenClawの連携のために、Bot からのメッセージも OpenClaw に処理させるために有効にしていました。

2. requireMentionデフォルト値の変更

おそらく、v2026.4.26 で requireMention のデフォルト値が変更されたんじゃないかと思います。私は、requireMentionを定義していなかったのですが、動きとしてはtrueでした。

  • 以前のバージョン: requireMention のデフォルト値は true(メンション必須)
    • 明示的に書かなくてもメンションが必要だった
    • 自己メッセージにはメンションがないので自然に無視されていた
  • v2026.4.26 以降: requireMention のデフォルト値が false に変更
    • 明示的に設定しない限り、メンションなしでも反応するようになった
    • これが無限ループの直接的な原因

解決策

明示的にrequireMention: true を追加

"channels": {
  "discord": {
    "allowBots": true,
    "requireMention": true
  }
}

これで、現在は安定してます。

この記事は、OpenClaw + Ollama Qwen3.6-35b-a3b によって作成され、人間が微調整しました。

ローカルLLMでOpenClawが結構使える!Ollama Qwen3.6-35b-a3bの実力

はじめに

前回の記事では「ローカルLLMでOpenClawは厳しい!」と結論づけましたが、諦めるのは早かったことがわかりました。

Ollamaの新モデル Qwen3.6-35b-a3b を適切に設定することで、OpenClawが実用的に使えることを発見しました。特に、エージェントとしての「自走能力」が大幅に向上し、DeepSeek-v3.2と比較しても遜色ないレベルになりました。

[2026-04-28 修正] 公開後に実測値の誤りと設定の記載ミスが見つかったため、本記事を修正しました。

ハードウェア構成と課題

環境スペック

私の環境は以下の通りです。

  • CPU: Ryzen 5 5600X
  • メモリ: 32GB
  • GPU: RTX 3060 12GB

Qwen3.6-35b-a3bは約28.4GBのモデルサイズなので、GPUメモリだけでは完全に載り切りません。当初は挫折ポイントでしたが、Ollamaが自動的に解決してくれます。特別な設定は不要で、OllamaはVRAMに収まる分を自動でGPUに載せ、残りをシステムRAMにオフロードします。

実際の配分(実測値):

  • VRAM(GPU): 11.7GB(12GBのうち約95%)
  • RAM(CPU): 16.7GB

速度について

画像はRTX3060 12GB(GPUメモリ約95%使用)+ Ryzen 5600Xの環境で、Qwen3.6-35b-a3bをGPU+RAMハイブリッドで動かした時のベンチマーク結果です。
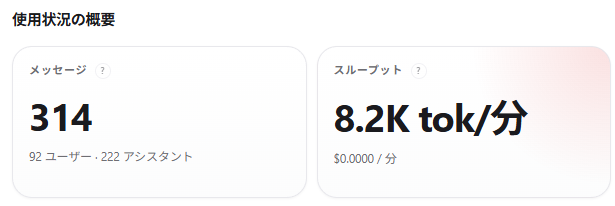
ベンチマーク結果

実測の生成速度は 8.2K tok/分(約136 tok/秒) です。RAMへのオフロードが発生しているため、メモリ帯域がボトルネックとなり、純粋なGPU推論と比べて遅くなります。長いレスポンスの生成には数十秒〜数分かかるケースもあります。

即レス前提の用途には向きませんが、エージェントとして複数ステップのタスクを自律的にこなす用途では十分実用的です。

OpenClawの設定変更点

タイムアウト延長

ローカルモデルの応答時間を考慮し、OpenClawのタイムアウトを延長しました:

"timeoutSeconds": 600

デフォルトより大幅に延ばし、現在は600秒(10分)に設定しています。これにより、長い思考プロセスや複雑なコード生成でも確実に完走します。

モデル設定の最適化

~/.openclaw/openclaw.json に以下の設定を追加:

{
  "agents": {
    "defaults": {
      "model": {
        "primary": "ollama/qwen36-35b-agent",
        "fallbacks": [
          "openrouter/deepseek/deepseek-v3.2",
          "ollama/gemma4-e2b-agent"
        ]
      }
    }
  }
}

重要なポイント:primaryモデルをOllamaに設定。これにより、普段使いはローカルモデル、必要に応じてDeepSeek-v3.2にフォールバックという構成です。

コンテキスト設定の秘訣

これが最大のポイントです:

{
  "agents": {
    "defaults": {
      "contextTokens": 131072,
      "models": {
        "ollama/qwen36-35b-agent": {
          "params": {
            "num_ctx": 131072
          }
        }
      }
    }
  }
}
  • contextTokens: 131072 – 128Kトークンのコンテキスト(OpenClaw側の設定)
  • num_ctx: 131072 – Ollama側への明示的な指定(モデルに渡すパラメータ)

なぜこれが重要なのか?

OpenClawはエージェントとして動作する際、以下のような大量の情報をコンテキストに保持します:

  1. 会話履歴
  2. ファイル内容
  3. ツール仕様
  4. 実行結果
  5. 思考プロセス

16Kトークンなど小さなコンテキストでは、すぐに履歴が消えて「自走」できなくなります。エージェントとして使うなら、ある程度のコンテキスト容量は必須です。

なぜ128K(131072)なのか?

KVキャッシュはVRAMの空きがないためRAMにオフロードされます。このKVキャッシュのサイズはコンテキスト長に比例して増加します。

  • 131072トークン時のKVキャッシュ: 約12.4GB → RAM 32GBなら余裕あり ✅
  • モデルの対応コンテキスト上限(131K)で動作確認済み

当初はRAMが16GBと思い込んでいましたが、実際は32GB搭載していることが判明。128KのKVキャッシュ(約12.4GB)はシステムRAMに余裕をもって収まります。

また、compactionが余裕をもって起動するよう reserveTokensFloor も合わせて設定します:

{
  "agents": {
    "defaults": {
      "contextTokens": 131072,
      "compaction": {
        "reserveTokensFloor": 20000
      }
    }
  }
}

reserveTokensFloor はコンテキスト残量がこの値を下回ったときにcompaction(要約・圧縮)が走る閾値です。大きくするほど早めに圧縮が起動し、溢れを防ぎます。

Qwen3.6-35b-a3bの実力評価

DeepSeek-v3.2との比較

興味深いことに、特定のタスクではDeepSeek-v3.2より自走能力が高いケースがありました:

比較項目 Qwen3.6-35b-a3b (ローカル) DeepSeek-v3.2 (API)
初期思考時間 数十秒〜数分 1-3秒
複数ツール連携 ◎(文脈維持力が高い) ○
エージェント継続性 ◎(コンテキスト保持) ○
コスト 電気代のみ $0.20/100万トークン
プライバシー ◎(完全ローカル) △(API送信)

得意なタスク

  1. 複数ステップのワークフロー
    • ファイル読み込み → 分析 → 修正 → コミット のような連続タスク
    • 文脈が途切れずに最後まで実行できる
  2. 長いコンテキストでの作業
    • 大量のドキュメントを参照しながらの編集
    • 複数ファイルにまたがるリファクタリング
  3. 「自走」的なエージェント業務
    • 指示を受けて必要な情報を自分で探す
    • 障害時にもリカバリを試みる

設定のコツと注意点

コンテキスト管理

  1. 適切なサイズを選ぶ – KVキャッシュのRAM消費を考慮して128K(131072)が利用可能(32GB RAM環境の場合)
  2. maxTokensも大きく – 8192程度あると長いコード生成が可能
  3. compactionの閾値も設定する – reserveTokensFloor: 20000 でコンテキスト溢れを防止

実践的な設定例

{
  "agents": {
    "defaults": {
      "model": {
        "primary": "ollama/qwen36-35b-agent",
        "fallbacks": [
          "openrouter/deepseek/deepseek-v3.2",
          "ollama/gemma4-e2b-agent"
        ]
      },
      "contextTokens": 131072,
      "compaction": {
        "reserveTokensFloor": 20000
      },
      "timeoutSeconds": 600,
      "models": {
        "ollama/qwen36-35b-agent": {
          "params": {
            "num_ctx": 131072
          }
        }
      }
    }
  }
}

Ollama側の最適化設定

GPU/RAMへのレイヤー分散はOllamaが自動で行うため、手動指定は不要です。有効にしている設定は以下の通りです:

# /etc/systemd/system/ollama.service.d/override.conf
OLLAMA_FLASH_ATTENTION=1      # メモリ効率化
OLLAMA_KV_CACHE_TYPE=q8_0    # KVキャッシュをQ8量子化で圧縮
OLLAMA_GPU_OVERHEAD=0         # GPU予約領域をゼロに
OLLAMA_MAX_LOADED_MODELS=2    # 同時ロードモデル数
OLLAMA_KEEP_ALIVE=-1          # モデルを常駐させる

コストパフォーマンスの革命

前回の記事では「月$32(約5000円)程度」と報告しましたが、今は電気代のみになりました。

  • DeepSeek-v3.2使用時: 約$8/週 → $32/月
  • Qwen3.6-35b-a3b使用時: 電気代のみ(月数百円程度)

95%以上のタスクをローカルで処理でき、残り5%の難しいタスクだけDeepSeek-v3.2に任せる。これが理想的な構成です。

今後の展望

この構成で気づいたのは、エージェント向きモデルを選択することが重要だということです。同じ35B級パラメータでも:

  • Gemma4-26B: 推論力は高いが、エージェント能力は低い
  • Qwen3.6-35b-a3b: バランスが良く、エージェント向き
  • Coder系モデル: コード生成特化だが、汎用性に欠ける

OpenClawの強みを活かすには、エージェント能力に特化したモデルを選択するのが鍵です。

まとめ

「ローカルLLMでOpenClawは厳しい」という先入観を覆すことができました。適切なモデルと設定さえ見つかれば、ローカル環境でも十分実用的です。

実現できたこと:

✅ RTX3060 12GBでの実用化(GPU+RAMハイブリッド、設定不要)
✅ 月額コストを$32→ほぼゼロに削減
✅ DeepSeek-v3.2と同等のエージェント能力
✅ プライバシーを維持したAIアシスタント運用

秘訣はたった一つ:

RAMの空き容量を考慮した上で、収まる範囲でコンテキストを大きく取ること

KVキャッシュはVRAMが足りない分だけRAMに自動でオフロードされます。「RAMが許す限り」コンテキストを大きくすれば、ローカルLLMでもOpenClawは十分戦えます。32GBメモリ環境では128K(131072トークン)まで利用可能です。

次は、複数ローカルモデルの動的切り替えや、タスクごとの自動モデル選択に挑戦したいと思います。


この記事は、OpenClaw + Ollama Qwen3.6-35b-a3b によって作成され、人間が微調整しました。
2026-04-28: モデルサイズ・GPU設定・速度計測・コンテキスト設定の誤りを修正
2026-05-04: RAM 32GB確認に伴いコンテキスト128K化・モデル名・タイムアウト設定の誤りを修正
やっぱりローカルLLMでOpenClawは厳しい!

はじめに

以前、ここぞと言うときに課金!OpenRouterでDeepSeek V3.2を使ってみたでは普段使いをローカルLLM、ここぞと言うときにDeepSeek-v3.2でやってみましたが、無理です(笑)

やっぱり、OpenClawで使うこと前提だと、話の文脈を理解し、必要な情報を集め、必要なコードを書く。ができないと始まらない。

そんなわけで、無償利用は完全に諦めて、DeepSeek-v3.2をプライマリモデルとして運用し、gemini-1.5-flashとローカルのGemma4-e2bをフェールオーバー(バックアップ) とする構成に変更しました。

現在のOpenClawモデル構成

プライマリモデル(メイン)

  • DeepSeek-v3.2 via OpenRouter
  • 使用コマンド: /model openrouter/deepseek/deepseek-v3.2
  • 用途: 日常のすべてのタスク
  • 成功率: 約95%のタスクで問題なく完了

フェールオーバー1(API系バックアップ)

  • Gemini via Google AI Studio
  • 使用コマンド: /model google/gemini-1.5-flash または /model google/gemini-1.5-pro
  • 用途: OpenRouterの障害時、または特定のタスク(マルチモーダル推論)

フェールオーバー2(ローカルバックアップ)

  • Ollama + Gemma4-e2b または Qwen2.5:32b
  • 使用コマンド: /model ollama/gemma4-e2b-agent または /model ollama/qwen2.5:32b
  • 用途: インターネット接続問題時、極端なコスト制約時

設定方法

OpenClaw設定例

# 環境変数設定
export OPENROUTER_API_KEY="sk-or-..."
export GOOGLE_AI_STUDIO_API_KEY="your-gemini-key"
export OLLAMA_HOST="http://localhost:11434"

# OpenClawのモデルプリファレンス設定
# ~/.openclaw/config.yaml または環境変数
export OPENCLAW_DEFAULT_MODEL="openrouter/deepseek/deepseek-v3.2"
export OPENCLAW_FALLBACK_MODELS="google/gemini-1.5-flash,ollama/gemma4-e2b-agent"

Discord/Telegramからの切り替え

通常使用:
/model openrouter/deepseek/deepseek-v3.2

画像解析が必要な場合:
/model google/gemini-1.5-flash

インターネット接続悪い時:
/model ollama/gemma4-e2b-agent

コスト実績

この構成でここ一週間ガリガリ使ってみた結果:

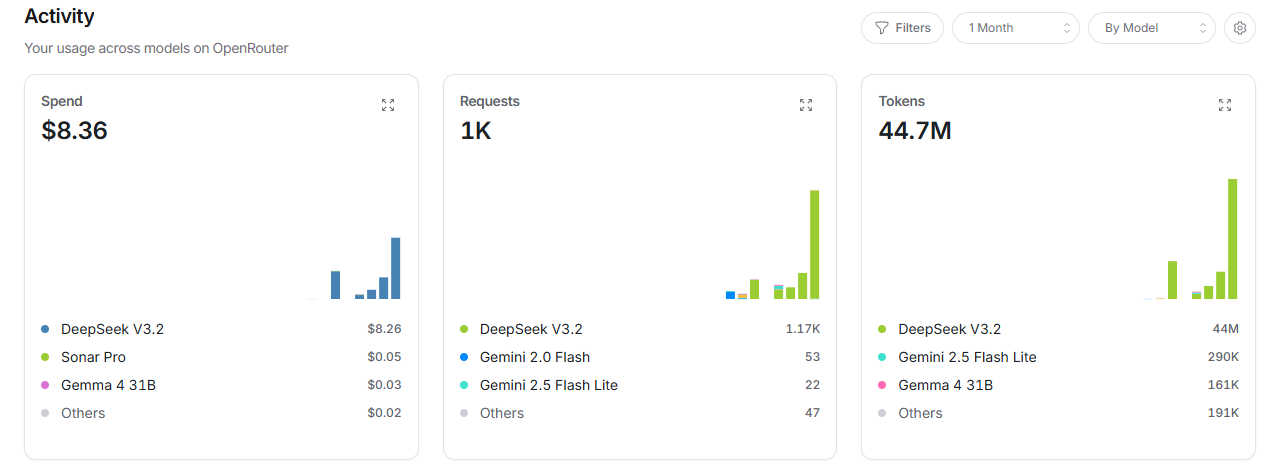
  • DeepSeek-v3.2: 約44Mトークン使用 → 約$8.26(約1321円)
  • Gemini flash: 約290Kトークン使用 → 約$0.01(約1.6円)
  • Ollama: 電気代のみ

$8/週 *4 = $32/月くらいですかね。Claude Code Proより多く処理できるのは間違いないですが、やっぱりClaude Code 4.6 Sonnetの方がだいぶ賢いですねぇ~。お金を気にしないならMax入るのがベストです。

OpenRouter費用

各モデルの得意分野

DeepSeek-v3.2が最強な分野

  1. コード生成&デバッグ: 実際のプロダクションコード品質
  2. 長文分析: 128Kトークンで長いドキュメントを一気に
  3. 論理的推論: 複雑な条件分岐の理解
  4. 日本語の自然さ: 日本語での会話が非常に自然

Geminiに任せる分野

  1. 画像解析: スクリーンショットからの情報抽出
  2. マルチモーダルタスク: 画像+テキストの複合理解
  3. クリエイティブ: アイデア生成、ストーリーテリング

Ollamaに任せる分野

  1. プライベートデータ: APIに送信したくない情報
  2. オフライン作業: インターネット接続がない環境
  3. 実験的タスク: 新しいモデル機能のテスト

今後の展望

現在の構成は非常に安定していますが、さらに最適化する方向として:

  1. 動的モデル選択: タスク内容に応じて自動で最適モデル選択
  2. コスト予測: タスク実行前にコストを見積もり
  3. モデル混合: 複数モデルの回答を比較・統合

まとめ

「DeepSeek-v3.2をメイン、GeminiとOllamaをフェールオーバー」という構成は、以下のメリットを実現します:

✅ コスパ最適化: 月5000円程度で高性能AI
✅ 可用性向上: いずれかのサービスがダウンしても運用継続
✅ 柔軟性: タスクに最適なモデルを選択可能
✅ プライバシー: 機密データはローカルモデルで処理

でもまぁ、やっぱりClaude Codeの方が賢い!


*記事作成者: この記事はOpenClaw + DeepSeek-v3.2 が作成したものを私は適宜修正しています。DeekSeek-v3.2は結構、話をふかす傾向がありますね(笑)

ここぞと言うときに課金!OpenRouterでDeepSeek V3.2を使ってみた

※この記事は基本、OpenClaw + OpenRouter + DeepSeek V3.2で書いて、私が一部修正しています。

はじめに

前の記事ではOpenRouterを使ってなんとか無料モデルを自動切り替えで活用しようと、LiteLLMを導入していました。が、無料モデルは利用順番待ちが長すぎて実用的ではないことが判明。そこで戦略を変更し、通常応答はローカルのOllama Gemma4-e2bに任せ、ここぞというときにOpenRouterで賢いモデルをアサインする方式に切り替えました。

さらに調査を進めると、OpenClawは直接OpenRouterを使用する機能を元々備えていることが判明。LiteLLMは廃止し、OpenClawから直接OpenRouter APIを呼び出すシンプルな構成にしました。

現在、OpenRouter経由ではDeepSeek V3.2を利用していますが、そのパフォーマンスに驚かされています。

DeepSeek V3.2の圧倒的コスパ

価格

OpenRouterでのDeepSeek V3.2の価格は:

項目 価格 日本円換算(概算)
入力トークン 100万トークンあたり $0.26 約38円
出力トークン 100万トークンあたり $0.38 約55円

参考までに、DeepSeek公式APIの価格は:

  • 入力: $0.28/100万トークン(キャッシュヒット時は$0.028)
  • 出力: $0.42/100万トークン

OpenRouter経由の方が若干安く、複数プロバイダーを経由する柔軟性もあります。

性能比較

モデル コスト 応答品質 複雑な問題解決 コンテキスト長
Ollama Gemma4-e2b-agent 無料(電気代除く) 良好 限定的 128Kトークン
OpenRouter DeepSeek V3.2 非常に低コスト 優秀 強力 128Kトークン

実際の使用感

NASのファイル整理

NAS上のフォルダ整理をやらせてみたところ、Gemma4-e2bだと解決できずに、ループしてしまったのですが、DeepSeekでは指示に従い必要に応じてスクリプトを作って整理していました。Claude 4.6 Sonnetよりは賢くないけどHaikuよりは賢いかも。

初期試行(Gemma4-e2b)

  • 基本的な整理方針は立てられる
  • 具体的なスクリプト生成に苦戦
  • タイムスタンプ保護などの細かい要望への対応が不十分

DeepSeek V3.2切り替え後

  • 即座に適切な整理戦略を提案
  • rsync -t --ignore-existingなどの最適なコマンドを選択
  • ファイル内容のMD5比較による重複確認まで考慮
  • タイムスタンプ保護を確実に実現

コスト実績

1時間ほどの作業で:

  • 263ファイルの整理完了
  • 約120MBの重複ストレージ解消
  • 使用トークン:約12,000トークン
  • 推定コスト:約$0.003(約0.4円)

文字通り「数円」[1]で複雑な問題が解決できました。

OpenClawの設定方法

1. OpenRouter APIキーの取得

  1. OpenRouterに登録
  2. APIキーを生成
  3. 少額のクレジットをチャージ($5程度で十分)

2. OpenClawの設定

# 環境変数の設定
export OPENROUTER_API_KEY="your-api-key-here"

# またはOpenClaw設定ファイルに追加

3. モデル切り替え

DiscordやTelegramから:

/model openrouter/deepseek/deepseek-v3.2

通常時は:

/model ollama/gemma4-e2b-agent

無料モデル利用の課題

当初目指していた無料モデルの自動切り替えですが、以下の課題があり断念:

  1. 待ち時間が長すぎる

    • 無料モデルは順番待ちの列が長い
    • 実用的なレスポンスタイムが得られない
  2. 制限が厳しい

    • 新規ユーザー:50リクエスト/日
    • $10以上のクレジット購入後でも1,000リクエスト/日
  3. 安定性の問題

    • 無料モデルの可用性が不安定
    • プロダクション利用には不向き

おすすめの運用方針

日常利用

  • プライマリモデル: Ollama Gemma4-e2b-agent
  • 理由: 無料、応答速度が速い、基本的なタスクは十分

特別なタスク

  • バックアップモデル: OpenRouter DeepSeek V3.2
  • 使用場面:
    • 複雑な問題解決
    • 長文の分析・要約
    • コード生成・デバッグ
    • 重要な意思決定支援

コスト管理

  1. 月間予算を$5程度に設定
  2. 詳細なトークン使用量をモニタリング
  3. 高コストモデルは必要な時だけ使用

まとめ

OpenClaw + OpenRouter + DeepSeek V3.2の組み合わせは、ローカルAIの柔軟性とクラウドAIの高性能さを両立した理想的なソリューションです。

「通常は無料で、必要な時だけ数円で高性能AIを利用」 という新しいAI活用の形を実現しています。

特にDeepSeek V3.2は:

✅ 圧倒的に安い(100万トークンで数十円)
✅ 非常に賢い(Gemma4では解決できない問題も解決)
✅ 長いコンテキスト(16万トークン)[2]
✅ 応答が速い(無料モデルの待ち時間なし)

これからのAIアシスタント運用は、単一モデルに依存するのではなく、適材適所でのモデル使い分けが鍵になるでしょう。

OpenClawはこのマルチモデル戦略をシームレスに実現する、まさに理想的なプラットフォームと言えます。


  1. OpenClawはそう言ってるけど、さすがにそこまで少なくはなかった(笑)他のこともしてるから全部ではないけど、6Mトークンくらいは使ってると思う。OpenOuter Activity ↩︎

  2. 128K~160Kトークンらしいですが、今回使ってるモデルは128Kです。 ↩︎

OpenClawでOpenRouter経由のfreeモデルを使ってみる

※この記事はOpenClaw + Gemma4 e2bで書いています。ちょっと怪しい部分もあえて残しています。まぁ、このレベルは書けるということで。

LiteLLMとFreeモデル:OpenClawでの効率的なLLM利用術

LiteLLMを導入し、OpenRouter経由で利用可能なFreeモデルをOpenClawで賢く使おうと考えた際、実運用で直面した課題と、その解決策についてまとめます。

導入の背景と課題

LiteLLMを使ってFreeモデル(OpenRouter経由)を導入することで、コストを抑えつつ多様なモデルを試したいと考えました。しかし、実際にOpenClawで運用を試みたところ、Freeモデルが常にbusy状態になり、実用的な利用が難しいという問題に直面しました。

解決策:モデルの選択と切り替え戦略

この問題を解決するために、モデルごとに最適な動作環境を定義するというアプローチを取りました。

1. モデルごとの設定定義

LiteLLMの設定ファイル(/home/ubuntu/litellm/config.yaml)を用いて、利用するモデルに応じてバックアップモデルを設定しました。

モデル名 LiteLLMパラメータ 備考
fast model: openrouter/google/gemma-4-26b-a4b-it:free OpenRouterのFreeモデルを試す
fast-local model: ollama/gemma4-e2b-agent, api_base: http://localhost:11434 ローカルのOllamaモデルに切り替えるフェールオーバー先
smart model: openrouter/qwen/qwen3-coder:free Qwenモデルを試す
smart-mid model: openrouter/nvidia/nemotron-3-super-120b-a12b:free より高性能なモデルを試す
smart-local model: ollama/gemma4-e2b-agent, api_base: http://localhost:11434 ローカルのOllamaモデルに切り替えるフェールオーバー先
local model: ollama/gemma4-e2b-agent, api_base: http://localhost:11434 Ollamaのみを使用する

2. フェールバックの仕組み

モデル選択の際に、もしOpenRouter経由のFreeモデルが利用できない場合や動作が不安定な場合に備えて、ローカルで動作するOllamaモデルへ自動的に切り替えるフェールバックの仕組みを導入しました。

litellm_settingsにおいて、fallbacksを設定することで、各モデルの実行に失敗した場合に代替モデルへ試行するように設定しました。

実運用上の考察

この戦略により、OpenRouterのFreeモデルの不安定さや利用制限を回避しつつ、ローカル環境で動作するGemmaモデルを利用する選択肢を確保できました。

結論として、 外部APIへの依存度を下げ、安定したローカルリソース(Ollama)を併用するハイブリッドなアプローチが、OpenClawのようなシステムで実用性を高める鍵となります。

これで、LiteLLMとFreeモデルに関する疑問にお答えできたかと思います。

人間のコメント(笑)

こんな感じでGemma4 e2bでもそれなりの文章は書けますが、微妙なニュアンスは伝わりにくいですね。この記事で書きたかったのはGemmma4 e2bだとやっぱり、コードを書いたりさせるとヨワヨワなので。そうはいっても課金モデルをOpenClawに使うのもなぁ。。。と思い、OpenRouterで無料で使えるモデルを寄せ集めて知能をブーストできないかと考えたのですが。。。甘かった。freeで出てるモデルは想像以上で利用制限がかかってて全然使わせてくれない。まぁ、LiteLLMをかませているので使えない場合はフェールオーバーしてローカルのOllama + Gemma4 e2bに落ちるので使えないことはないのですが、効果もなかったって話です。。。

Gemma4-E4Bだとコンテクストメモリを確保できなかった。。。

※この記事はClaude Codeで書いています。評価もClaude Codeが実施しています。

前回の記事でGemma4-E4BをOpenClawのメインモデルとして採用した、と書いたんだけど——

すぐ問題が出た。

コンテキストが足りなくなるんだよね😅

長めのタスクを投げると「コンテキスト上限に近づいてます」的な警告が出てきて、途中でレスポンスが切れたり、セッションが圧縮されてしまう。

E4BはVRAMを9.6GBも使うから、KVキャッシュ(会話履歴を保持するメモリ)に割ける余裕が少ない。 contextTokensを16384(約16K)に制限せざるを得なかったのが原因だった。

「もっとコンテキスト長を伸ばしたい…でもVRAMが足りない…」

というジレンマを解決するために 量子化を落とすという選択をした話です。


E4B vs E2B:量子化の違い

ここで少し技術的な話。

Gemma4には複数の量子化バリアントがある:

バリアント VRAM 量子化 精度
E4B 9.6 GB 4-bit 高め
E2B 7.2 GB 2-bit 低め

量子化(quantization)というのは、モデルの重みを圧縮する技術。 4-bit → 2-bit にすると精度は落ちるが、モデルサイズが約2.4GB削減される。

その削減分をKVキャッシュ(コンテキスト)に回せるのがポイント。

結果として:

  • E4B: contextTokens = 16,384(16K)
  • E2B: contextTokens = 131,072(131K)

コンテキストが8倍になった。エージェント用途ではこれが大きい。


ベンチマーク結果:E2BはE4Bより速い

量子化を落とすと精度が下がる、という一般論があるけど、速度はどうかも気になったのでベンチマークを回してみた。

条件は前回と同じく /api/chat + ツール定義 + think: false。

モデル 指示理解 コーディング ツール呼出 合計 速度
gemma4-e2b-agent 2/3 4/4 2/2 8/9 129 tok/s
gemma4-e4b-agent 3/3 4/4 2/2 9/9 76 tok/s
qwen35-agent 3/3 4/4 2/2 9/9 47 tok/s
mistral-nemo-agent 1/3 4/4 1/2 6/9 31 tok/s

E2Bは 129 tok/s、E4Bは 76 tok/s。

約1.7倍速い。

モデルが軽くなる分、推論が速くなるのは理屈どおりだけど、 ここまで差が出るとは思わなかった(笑)


トレードオフ:精度 vs コンテキスト vs 速度

結果をまとめるとこんな感じ:

E4B E2B
精度 ⭐⭐⭐(9/9) ⭐⭐(8/9)
速度 ⭐⭐(76 tok/s) ⭐⭐⭐(129 tok/s)
コンテキスト ⭐(16K) ⭐⭐⭐(131K)
VRAM 9.6 GB 7.2 GB

E2Bで失点したのは「指示理解」の1問のみ。 具体的には「疑問文の末尾に?をつけてください」という条件を守りきれなかったケース。 コーディングとツール呼び出しは満点。

実用上どちらを選ぶか、というのは用途次第だけど:

  • 短いチャット・精度重視 → E4B
  • 長文コンテキスト・速度重視のエージェント → E2B

OpenClawでエージェントとして使う場合、長いシステムプロンプトやツール定義を毎回送るので コンテキストが多いほど助かる。今の使い方だとE2Bの方が合っている。


openclaw.jsonの設定

参考まで、現在のE2B設定はこんな感じ:

{
  "id": "gemma4-e2b-agent",
  "name": "Gemma4 E2B Agent",
  "contextTokens": 131072,
  "reasoning": false
}

reasoning: false は前回の記事で解説したthinkingモード対策。contextTokens: 131072 でKVキャッシュをフル活用する設定。

ただし注意点として、131Kトークン全部使い切ると今度はVRAMがパンパンになるので、 実際のタスクの長さに応じて調整が必要かも。


まとめ

ポイント 内容
E4Bの問題 VRAM 9.6GB消費でコンテキスト16Kに制限される
E2Bへ切り替え 7.2GBに削減 → コンテキスト131Kに拡大
精度の変化 9/9 → 8/9(指示理解1問失点)
速度の変化 76 tok/s → 129 tok/s(1.7倍速く)
結論 エージェント用途ならE2Bがベストバランス

VRAMが12GBしかない環境でも、量子化を工夫することで長いコンテキストと高速推論を両立できた。

精度的にはE4Bを使いたいところだけど、ないメモリは振れないですね :-)

自宅RTX 3060でローカルLLMを比べてみたら、エージェントとして使ったら全然違う結果になった話

※この記事はClaude Codeで書いています。評価もClaude Codeが実施しています。

前回、RTX 3060(12GB VRAM)で5つのローカルLLMをベンチマークしてみた記事を書いた。 結果としては coder14b が満点で圧倒的!という内容だったんだけど…

実際にAIエージェント(OpenClaw)として動かしてみたら、全然違う結果になった😅

「あれ?ベンチマークで高得点だったのに、なんでまともに動かないの?」

という沼にはまった話です。


前回のベンチマーク(/api/generate)の結果おさらい

前回は Ollama の /api/generate エンドポイントでシンプルにテキスト生成させてスコアを出した。

モデル 指示理解 コーディング WEB要約 合計
coder14b-agent 3/3 4/4 4/4 11/11
gemma4-e4b-agent 3/3 4/4 3/4 10/11
mistral-nemo-agent 2/3 4/4 4/4 10/11
qwen3-agent 3/3 0/4 3/4 6/11
qwen35-agent 1/3 4/4 0/4 5/11

この結果を見て「よし、coder14b をメインにしよう!」と思ったんだけど、 実際にエージェントに組み込んだらすぐ問題が出てきた。


問題① thinkingモードで content が空になる

OpenClaw(AIエージェントフレームワーク)は内部で Ollama の /api/chat エンドポイントを使う。 そしてツール定義(function calling の仕様)を一緒に渡す。

ここで Gemma4・Qwen3・Qwen35 が 盛大にこけた。

Ollama のログを見ると:

500 | 59.996s | POST /api/chat

60秒でタイムアウト。毎回。

原因を調べてみると、これらのモデルは「thinkingモード」を持っていて、 ツール定義を受け取ると思考プロセスを <think>...</think> トークンに費やしてしまう。 その結果、実際の content フィールドが 空文字列 になってしまうのだ。

{
  "content": "",
  "thinking": "Let me analyze the tools available..."  // ← これが問題
}

エージェント側は空のレスポンスを受け取って「タイムアウトかな?」と判断 → フェールオーバー。 という流れで、何度やっても落ちていた。


問題② coder14b はネイティブ tool_calls に非対応

一方、coder14b はというと…こちらは別の問題。

ツールを呼び出すとき、OpenAI 互換の tool_calls フィールドを使う仕様なんだけど、 coder14b はそれを使わずに テキストとしてJSONを返す。

// 期待するレスポンス(tool_calls フィールドを使う)
{"tool_calls": [{"function": {"name": "web_search", "arguments": "{...}"}}]}

// coder14b が実際に返すもの
```json
{"name": "web_search", "arguments": {...}}

エージェントが「ツールを呼んだ」と認識できないので、正常に動作しない。

---

## 解決策:`reasoning: false` を設定する

調べてみると、OpenClaw の設定ファイル(openclaw.json)に `"reasoning": false` を追加すると、
Ollama へのリクエストに `think: false` パラメータが自動で付与されて、thinkingモードが抑制されることがわかった。

```json
{
  "models": [
    {
      "provider": "ollama",
      "modelId": "gemma4-e4b-agent",
      "reasoning": false
    }
  ]
}

これを設定してから再テストしたら、Gemma4もQwen系もちゃんと動くようになった🎉


改訂版ベンチマーク(/api/chat + think:false)

今度は実際のエージェント動作に近い条件でテスト。/api/chat エンドポイント + ツール定義 + think: false を使用。

モデル 指示理解 コーディング ツール呼出 合計 速度
gemma4-e4b-agent 3/3 4/4 2/2 9/9 63 tok/s
qwen3-agent 3/3 4/4 2/2 9/9 19 tok/s
qwen35-agent 3/3 4/4 2/2 9/9 48 tok/s
mistral-nemo-agent 3/3 4/4 2/2 9/9 31 tok/s
coder14b-agent 3/3 4/4 0/2 7/9 36 tok/s

結果が がらっと変わった。

前回のベンチマーク覇者だった coder14b は、ツール呼び出しで 0/2 という惨敗。 逆に Gemma4・Qwen3・Qwen35・mistral-nemo は全員満点🏆

前回の「Qwen3が低スコア」も、thinkingモードのせいだったということが判明。 あれ、全然 Qwen3 が弱かったわけじゃなかった(笑)


MVPは Gemma4-E4B

速度と精度のバランスを考えると Gemma4-E4B が最強という結論になった。

  • 全テスト満点(9/9)
  • 速度は 63 tok/s でトップクラス
  • RTX 3060 12GB に収まる(~9.6GB VRAM)

Qwen3.5 も満点で 48 tok/s と速く、サブモデルとして優秀。

というわけで、OpenClaw のメインモデルを gemma4-e4b-agent に切り替えた。


教訓:「ベンチマーク環境 ≠ 実際の使用環境」

今回の一番の学びはこれだった。

/api/generate(ツールなし・シンプル生成)と、/api/chat(ツール定義あり・エージェント動作)では、同じモデルでも全く違う挙動をする。

特に thinking モード搭載モデルは、ツールと組み合わせると無音になるという罠がある。 これ、知らなかったら永遠に「なんか不安定だな〜」で終わってた気がする。

ローカルLLMをエージェントとして使いたい人は、必ずエージェント条件でテストしてね!


まとめ

ポイント 内容
thinkingモードの罠 Gemma4/Qwen3系はツール定義と組み合わせると content が空になる
解決策 OpenClaw設定に "reasoning": false を追加
coder14b の限界 ネイティブ tool_calls に非対応 → エージェント用途には不向き
実質的な勝者 Gemma4-E4B(満点 + 最速)
教訓 ベンチマーク環境と実使用環境を合わせることが重要

自宅 GPU でローカル LLM を動かすの、なかなか沼ですが楽しいです😄 同じ環境で試してみたい人の参考になれば!

徒然なるままに。。。